Cada petición ya pesaba 45.000 tokens antes de empezar
En la nota 002 conté cómo reparto el trabajo: Claude Code decide y revisa, y los modelos baratos de OpenCode teclean. Ahí dejé escrita una lección que en ese momento solo era una queja: cada petición lleva unos 45–50k tokens entre instrucciones y herramientas, antes de que el agente haga nada.
Para quien no vive entre agentes: un token es un trozo de palabra, más o menos tres cuartos de una palabra en inglés. Todo lo que un modelo lee y escribe se cuenta en tokens. La cuota se gasta en tokens, y el contexto, que es lo que el modelo puede tener en la cabeza a la vez, también se mide en tokens. Si lo llenas de ruido, pagas más y el modelo piensa con menos espacio.
Esos 45.000 tokens de arranque no los puedo bajar mucho sin quitarle herramientas al agente. Así que dejé de mirar el arranque y empecé a mirar lo que pasa después.
Tres fugas: lo que el agente dice, lo que lee y cuántas veces pregunta
Cuando lo separé, vi que los tokens se iban por tres lugares distintos, y que cada uno pedía una herramienta distinta:
┌──────────────────────────────┐ lo que dice ◀─┤ │ → Caveman │ agente (modelo) │ lo que lee ─▶┤ terminal, tests, archivos │ → RTK │ │ cuántas veces ─┤ "¿puedo correr esto?" │ → OpenCode --auto pregunta └──────────────────────────────┘La primera es la más visible y la que menos pesa. La tercera es la que menos se ve y, según mi propio registro de la decisión, la que más importa:
El ahorro no viene de delegar más cosas baratas, viene de que haya menos idas y vueltas con el orquestador.
Voy en orden, de la más visible a la más escondida.
Caveman: que el agente hable como cavernícola
Caveman es una skill, un conjunto de instrucciones que el agente carga, que le pide responder como un cavernícola: sin artículos, sin relleno, sin cortesías, con frases sueltas. Un ejemplo para ilustrar la idea (lo escribí yo, no es una medición):
Antes: Claro, he revisado el archivo y parece que el problema podría estar en la función de validación, que no está comprobando el caso vacío.Después: Bug en validación. Caso vacío sin comprobar.La activo con un hook: un comando que Claude Code ejecuta solo en ciertos momentos, en este caso al empezar, al reanudar o al compactar una sesión. Ese hook le inyecta la regla en modo ULTRA, la versión más agresiva. Está en .claude/settings.json de este repo, así que cualquier sesión que abra aquí arranca hablando así.
Lo que más me importó al configurarlo no fue cuánto comprime, sino lo que nunca puede tocar:
- Nunca cambia código, nombres de funciones, comandos, mensajes de error, números ni unidades.
- Nunca se come las palabras no, nunca, solo ni excepto. Una instrucción comprimida que pierde un “no” dice lo contrario.
- Deja de comprimir en avisos de seguridad, en confirmaciones de algo irreversible y en pasos cuyo orden se podría malinterpretar.
- Solo comprime la conversación. La documentación y lo que lee una persona se escriben en prosa normal; esta nota, por ejemplo, no está escrita en cavernícola.
No medí cuánto ahorra Caveman. Lo dejo en lo que es: la fuga más pequeña, cerrada con poco esfuerzo.
RTK: la terminal resumida antes de que la lea el modelo
La segunda fuga es mucho más grande. Cuando un agente corre una suite de pruebas, la terminal escupe cientos de líneas: barras de progreso, rutas, avisos repetidos, cada prueba que pasó. El modelo se lee todo eso para encontrar las dos líneas que le importan.
RTK (se abre en una pestaña nueva) se pone en medio. Otro hook, rtk hook claude, se ejecuta antes de cada comando de terminal y lo pasa por RTK, que filtra la salida antes de que llegue al modelo. Para el agente es transparente: corre pnpm test como siempre y recibe una versión compacta que conserva las señales (qué falló, dónde, con qué error) y tira el ruido.
Esta es la parte que sí medí, porque RTK lleva la cuenta:
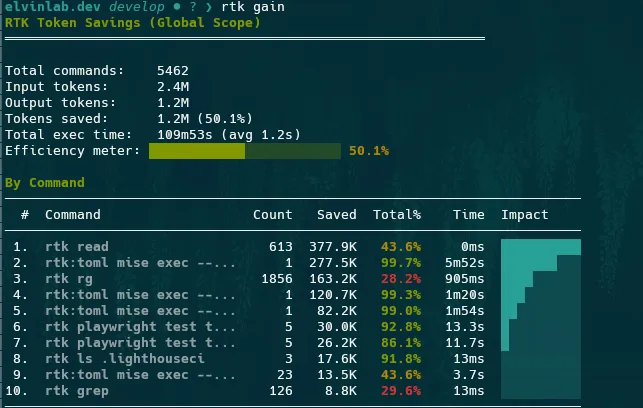
Leído en simple:
- De 2,4 M a 1,2 M tokens. En 5.462 comandos, la mitad de lo que la terminal habría metido en el contexto no llegó al modelo. Es el acumulado global, de todos mis repos, no solo de este.
- Leer archivos es lo que más suma.
rtk readahorró 377,9 K tokens en 613 lecturas, un 43,6 %. No es el porcentaje más alto, pero es lo que el agente hace todo el tiempo. - Las pruebas son donde más brilla. Una sola ejecución de
mise execde casi seis minutos ahorró 277,5 K tokens, un 99,7 %. Las corridas de Playwright ahorran entre un 86 % y un 93 %. - Buscar ahorra poco.
rtk rgse usó 1.856 veces y solo ahorró un 28,2 %. Mi lectura es que el resultado de una búsqueda ya viene corto, así que hay poco que quitar.
RTK no esconde nada para siempre. Cuando recorta, la salida dice cómo recuperarla: rtk recall <id> devuelve el texto completo, y rtk proxy <comando> corre el comando sin filtro. En el registro de verificación de este sitio hay líneas como “Full output: rtk recall 8cb0935b5183”, por si alguien tiene que mirar el detalle.
Por qué dejé que el modelo barato haga commit
La tercera fuga es la que no se ve en ninguna captura. Antes, cuando Claude le pasaba una tarea a OpenCode, el modelo barato avanzaba un paso y volvía: ¿puedo editar este archivo?, ¿puedo correr las pruebas?, ¿hago commit? Cada vuelta era un turno de Claude, y cada turno de Claude carga su contexto completo. El modelo barato salía barato; el ir y venir, no.
La decisión fue darle a OpenCode el trabajo entero: editar, correr comandos, probar y hacer commit, todo bajo --auto, sin volver a preguntar a cada paso. Claude sigue haciendo tres cosas que no delego:
- Leer el estado. Un
git statuso ungit diff --statya salen baratos gracias a RTK, así que delegarlos no ahorra nada. - Las tareas de nivel 3. Arquitectura, seguridad y depuración difícil siguen siendo de Claude.
- Revisar el diff. El commit lo hace el modelo barato; la revisión, Claude, antes de que nada salga de mi máquina.
Delegar más no es lo que ahorra. Lo que ahorra es delegar trabajo acotado (escribir, probar, explorar) de una sola vez, en vez de a pedazos.
Lo que no le dejo hacer
Darle autonomía a un modelo que a veces inventa (la 002 tiene un ejemplo) solo tiene sentido con un techo claro. El techo vive en la configuración de OpenCode: lectura, edición y búsqueda permitidas, cualquier comando de terminal permitido, y 14 reglas que lo prohíben todo lo que no tiene vuelta atrás o sale de mi máquina:
git push enviar código al repositorio remotowrangler, pnpm ... deploy desplegar a produccióngh pr merge, release, auth fusionar, publicar o tocar la sesión de GitHubrm -rf, rm -fr borrar carpetas enterasssh, scp, rsync mandar cosas a otra máquinaHay dos detalles que aprendí configurándolo y que no son obvios:
- Denegar, no preguntar.
--autoaprueba solo todo lo que no está explícitamente denegado, incluido lo que está marcado como “preguntar”. Una regla de “pregunta antes de hacer push” bajo--autoes una regla que no existe. Por eso lo peligroso esdeny. - El orden importa. OpenCode aplica la última regla que coincide. Si el “permitir todo” va al final, pisa las 14 prohibiciones. Va primero.
"bash": { "*": "allow", // primero: lo general "git push*": "deny" // después: lo específico gana // ...y las otras 13 prohibiciones}Lo probé en vivo antes de confiar en él. Con opencode run --auto y el modelo de nivel 1, git status --short corrió sin preguntar. git push --dry-run, que ni siquiera envía nada, fue rechazado: OpenCode citó la regla git push*: deny y listó las 15 reglas que tenía cargadas.
Lo que se rompió
Ninguna de las dos fallas hizo ruido. Ese fue justamente el problema.
RTK leía mi lint como si fuera de otra herramienta
Después de instalar RTK, pnpm lint dejó de dar un resultado útil. La salida decía:
ESLint output (JSON parse failed: EOF while parsing a value at line 1 column 0)RTK reconoce pnpm lint y lo pasa por su filtro de ESLint. Este repo no usa ESLint, usa Biome, así que el filtro esperaba un formato que nunca llegaba. La solución fue saltarse el filtro para ese comando: rtk proxy pnpm lint revisó 146 archivos sin nada que corregir. Lo dejé escrito en RTK.md para que el próximo agente no lo tenga que descubrir.
La lección: un filtro que adivina qué herramienta corres también puede adivinar mal.
Los modelos baratos llevaban tiempo sin trabajar
Esta me dolió más. Revisando la configuración, encontré que faltaba el archivo que le dice a herdr qué modelo usar para cada nivel (active.env). No faltaba solo el archivo, faltaba la carpeta entera.
Sin ese archivo, nada fallaba: OpenCode simplemente usaba su modelo por defecto. Las delegaciones funcionaban, los diffs llegaban, y ninguna pasaba por los combos baratos que describí en la 002. No sé desde cuándo estaba así. Lo arreglé creando el archivo con los dos combos, omniroute/elvinlabFast para el nivel 1 y omniroute/elvinlabCode para el nivel 2.
Es la misma lección que ya había escrito sobre los interruptores automáticos, ahora en otro sitio: lo que se degrada en silencio no avisa. Hay que ir a mirarlo.
Que sobreviva a una reinstalación
Todo lo anterior vive en archivos de configuración de mi usuario, no en este repo: el hook de Caveman, el de RTK, el estilo de salida, el techo de permisos de OpenCode y el archivo de modelos. Y el instalador que uso para configurar Claude Code (gentle-ai) puede reescribir parte de esos archivos en una reinstalación completa.
Para no perder el ahorro sin enterarme, escribí restore.sh. Es idempotente: se puede correr diez veces y el resultado es el mismo que correrlo una, porque solo agrega lo que falta. Revisa y repone seis cosas:
- El archivo de modelos por nivel (
active.env). - El hook de Caveman.
- El hook de RTK.
- El hook que le recuerda a Claude qué modelo usar en cada nivel al delegar.
- El estilo de salida.
- El techo de permisos de OpenCode.
Antes de tocar nada, guarda una copia de la configuración y conserva las últimas cinco. Probé cada camino de “reponer” sobre copias desechables, no sobre mi configuración real, y comprobé que el JSON seguía siendo válido. El script quedó en los dotfiles de agentic-dev-setup (se abre en una pestaña nueva), así que en una máquina nueva basta con correrlo después de instalar gentle-ai para recuperar todo el ahorro.
Lo que me cuesta
Nada de esto es gratis, y quiero dejarlo escrito igual que lo bueno:
- Un commit sin revisar llega a mi historial local. Claude revisa el diff después, no antes. Si algo está mal, se corrige o se revierte antes del push, pero el commit existió.
- Una lista de prohibiciones solo cubre lo que se me ocurrió. Con
--auto, todo lo que no está en las 14 reglas está permitido. Si mañana aparece un comando peligroso que no anticipé, el techo no lo frena. - RTK puede esconder la línea que importa. Casi nunca pasa, pero cuando pasa hay que saber que existe
rtk proxy. Y su filtro de lint ya me demostró que puede equivocarse de herramienta. - Solo uno de los tres ahorros está medido. RTK tiene su 50,1 %. Caveman y
--autono tienen número. Mi sensación es que ahorran bastante sin perder calidad, pero es una sensación, no una medición.
Y una corrección para la 002. Ahí escribí que los modelos baratos nunca envían código sin revisar. Sigue siendo cierto si “enviar” significa que salga de mi máquina: nada se sube sin que Claude revise el diff, y el push está denegado. Ya no es cierto si significa hacer commit: eso ahora lo hacen solos.
Si te pasa lo mismo
Lo que más me sorprendió no fue el 50 % de RTK, sino que la fuga más cara fuera la que no aparece en ningún contador: las veces que un agente vuelve a preguntar.
Si trabajas con agentes, me gustaría saber qué comando te llena más el contexto, o qué regla de permisos te salvó de algo. Cuéntamelo en los comentarios.
¿Te gustó? Deja tu huella
Anónimo: sin guardar tu IP ni datos. Ver privacidad